[편집자] 4차 산업혁명은 모든 사물과 인간을 연결하여 빅데이터를 모으고, 이를 이용하여 인공지능으로 학습해, 결국 인공지능이 인간을 대체하는 시대를 말한다. 이러한 4차 산업혁명의 물결이 산업뿐만 아니라 경제, 사회, 정치 등 전 분야에 걸쳐서 막대한 변화를 일으키고 있다.
글로벌뉴스통신사 뉴스핌은 '김정호의 4차혁명 오딧세이' 칼럼을 매주 연재하며 4차 산업혁명의 본질과 영향, 그리고 전망을 독자들에게 쉽게 소개하고자 한다. 4차 산업혁명의 핵심은 바로 인공지능, 빅데이터, 클라우드 컴퓨팅으로 표현할 수 있으며 그 핵심 부품이 반도체이다. 이들 핵심 기술의 개념과 원리, 응용을 설명하여 일반 독자들이 4차 산업혁명에 대해서 공감하고 이해하며 더 나아가 개인과 기업, 국가의 미래를 계획하는 것을 돕고자 한다.
김정호 카이스트(KAIST) 전기 및 전자공학과 교수는 서울대 전기공학과를 졸업하고 미국 미시건대에서 박사 학위를 받았다. AI대학원 겸임교수, IEEE펠로우, 카이스트 ICT석좌교수, 한화 국방 인공지능 융합연구 센터장, 삼성전자 산학협력센터장 등을 겸하고 있다.
데이터가 필요한 인공지능 학습
인공지능 중에서 데이터로 학습하는 방식을 기계학습(Machine Learning)이라고 하고, 그 기계학습 중에서 데이터에 이름(Label)을 붙여서 학습하는 방식을 지도학습(Supervised Learning)이라고 한다.
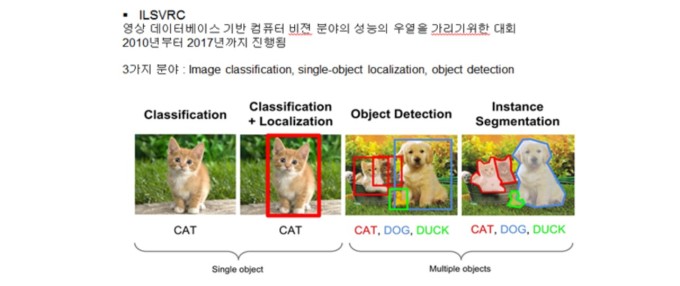
데이터에 이름을 붙여야 하는 인공지능 학습 방식이다. 대표적으로 이미지를 인식하는 CNN(Convolutional Neural Network) 알고리즘이 이 방식의 인공지능이 된다. 이미지와 이름을 보고 학습해서 물체를 판단해 낸다.
그런데 이러한 지도학습 방법은 많은 비용과 노동력이 필요해서 결국 시간과 자본이 들어간다. CNN 학습을 위해서는 수백만 장, 수천만 장의 사진을 모으고, 그 사진에 이름을 붙여야 한다. 이러한 작업에 개인이 자발적으로 이름을 붙일 수 있으나 그 한계가 있다.
구글과 페이스북은 인터넷과 SNS로부터 수많은 데이터인 사진 이미지를 모은다. 여기에 모두 직접 사람이 이름을 붙이기는 불가능에 가깝다. 그래서 구글과 페이스북은 사진 상황을 보거나, 해시태그를 이용해서 자동으로 그림에 이름을 붙이는 인공지능 알고리즘 연구를 하기도 한다. 이것이 모두 데이터에 이름을 붙이는 데 필요한 노력이다. 인공지능이 학습하는 데 필요한 비용이다. 데이터와 이름은 무료가 아니다.
사람 중에 똑똑한 사람을 '하나를 알려주면 열을 안다'라고 표현하기도 한다. 학생을 지도하다 보면 그런 학생을 종종 만난다. 나중에는 그 학생이 오히려 나에게 스승이 된다. 그런 학생들을 통해서 거꾸로 배운다. 이럴 때 학교에 있는 교수로 최고의 기쁨을 느낀다. 이런 학생은 스스로 학습하고 연구하는 독자적인 학습과 연구 수행능력을 갖추게 된다.
인공지능을 지도할 때도 마찬가지이다. 학습을 줄이고 최대한 인공지능의 지능을 높이고자 연구한다. 그러면 데이터 모집과 이름 붙이기 수고가 줄어들 수 있다. 그럼 척척 알아서 학습하게 된다.
최소한의 데이터로 인공지능 학습
이러한 연구 중, 최근에는 인공지능 연구로 전이학습(Transfer Learning)이라고 불리는 학습 방법이 있다. 한번 배운 학습 결과를 다른 곳에 다시 쓴다는 의미이다. 다시 말하면, 여러 번 배울 필요가 없다는 의미이다. 수학에서 기초 원리를 잘 파악하면 다양한 응용문제를 푸는 원리와 같다.
이처럼 한번 학습한 결과를 다른 응용에 적용하려는 시도를 전이학습(Transfer Learning)이라고 부른다. 학습과정에서 얻는 인공지능망의 구성과 변수도 다른 용도의 인공지능망으로 전이될 수 있다. 그럼 이를 전수한 새로운 인공지능 신경망은 학습량이 줄어든다. 아예 이러한 전체 과정을 스스로 할 수도 있다. 이 방법을 자체학습(Self-learning)이라고 부른다.
최근 연구하는 인공지능 학습 방법이다. 모두 학습 부담을 줄이고 데이터 필요 분량을 줄이려는 시도이다.
아예 한번 교육으로 모든 교육이 끝나는 단수학습(One short Learning) 방법에 대한 연구도 시작됐다. 수학에서 문제 하나만 풀어보면, 유사한 모든 문제를 푸는 능력이라 보면 된다. 천재를 키우는 인공지능 학습 방법으로 보면 된다.
예를 들면 어린이를 학습할 때, 공룡 사진 하나만 보여주면, 그 이름을 영원히 기억한다. 지금의 인공지능 학습은 많은 수의 사진을 보여주면서 학습하고 그 결과로 인공지능망이 정해진다. 단 한 번의 이미지 학습으로 인공지능망을 정하려는 시도인 셈이다.
매우 도전적이지만, 언제인가 인공지능이 이 단계에 도달할 것으로 본다. 이 학습 방법은 '하나를 가르쳐 주면 모든 것을 안다'라는 설명으로도 가능하다. 천재 학생 지도 방법이다. 이 방법 역시 데이터를 최소화하면서 인공지능을 학습하는 방법이라고 본다.
인공 데이터(Artificial Data)의 생성
인공지능에는 학습을 위한 데이터가 필요하다. 일반적으로 데이터가 많을수록 지능이 높아진다. 그래서 빅데이터를 모으려고 한다. 그래서 데이터도 인공적으로 만들려고 한다. 이를 필자는 인공 데이터(Artificial Data)라고 부른다. 인공지능(Artificial Intelligence)처럼 인공 데이터(Artificial Data)도 대세가 된다. 아예 사람의 도움을 받지 않고 인공지능 스스로가 인공지능 학습용 데이터를 만들 수 있는 세상이 된다.
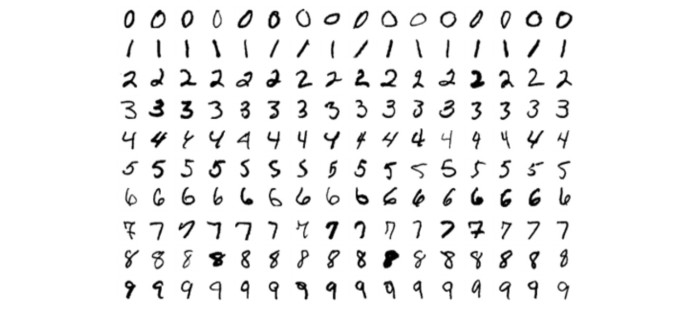
데이터를 인공적으로 만드는 방법은 제일 먼저 원본 이미지를 변형하는 방법이다. 글자를 인식하는 CNN을 위한 손글씨 데이터를 만든다고 하면, 기본 데이터 글씨(MNIST)를 기초로 컴퓨터가 그 글씨체를 변형할 수 있다.
아래위로 길게 늘이거나, 글씨체 자체를 기울이게 할 수 있다. 또는 흐리게 만들거나, 가늘게 만들 수 있다. 이미지에 잡음을 넣을 수 있다. 바탕도 바꿀 수 있다. 또는 색깔을 다르게 입힐 수 있다. 또는 글자 크기를 키울 수도 있다. 컴퓨터와 알고리즘을 결합하면 한 장의 기본 글씨 이미지로 수백 장, 수천 장의 파생 데이터를 컴퓨터로 만들 수 있다.
이렇게 기본 데이터를 변형해 빅데이터를 만들 수 있다. 이 빅데이터는 다시 인공지능 학습에 쓰인다. 인공(Artificial)이 돌고 돈다.
처음부터 아예 컴퓨터가 스스로 데이터를 만들 수 있다. 그 데이터로 인공지능이 학습한다. 예를 들어 자율주행자동차를 위한 학습용 사고 장면 영상을 만든다고 가정하자. 자율주행자동차 학습을 위해 영상을 직접 만드는 것은 매우 위험하고 비싸다. 따라서 사고 영상을 컴퓨터로 인공적으로 만들어 이를 이용해서 인공지능이 학습하는 것이 효율적이다.
제목과 주제를 주면 컴퓨터가 3차원 영상과 이미지를 만들어 내는 연구가 진행 중이다. 그렇게 되면 인공지능이 경험하는 세계도 인공적으로 컴퓨터로 만들어진다. 데이터를 만드는 시간과 비용, 수량의 한계를 인공 데이터 생성을 통해서 해결하려고 한다. 이런 방식을 필자는 데이터 증강(Data Augmentation)이라고 부르기도 한다.
그뿐만 아니라 강화학습(Reinforcement Learning)에서도 인공적으로 계산해서 학습한다. 강화학습에서는 게임을 하듯이 학습한다. 알파고가 이세돌 9단과 바둑을 둘 때 사용한 인공지능 학습 방법이다.
이제는 컴퓨터끼리 게임을 하면서 바둑 기보 데이터를 생산한다. 그러니 이 상황에서도 인공지능 학습을 위한 환경을 컴퓨터가 가상으로 만든다.
강화학습을 이용해서 공학 문제의 최적화 설계도 자동화하려는 시도가 시작되었다. 여기서도 컴퓨터 시뮬레이션으로 데이터가 만들어지고 이를 통해서 학습한다. 이렇게 되면 컴퓨터가 다 알아서 한다. 이제 학습에도 인간의 도움이 점점 덜 필요하게 된다. 학습도 컴퓨터가 담당한다.
가상 데이터(Virtual Data)인 세상
인공지능 학습을 위한 데이터를 모으는데 개인의 정보보호와 특허 문제가 발생한다. 학습을 위해 모은 데이터의 주인은 누구이고, 그 개인의 정보는 어디까지 보호해야 할 것인가가 사회적, 법률적, 정치적 쟁점이 될 전망이다. 그래서 빅데이터를 모으기가 점점 더 어렵게 되었다.
그래서 인공지능을 위한 빅데이터를 컴퓨터로 인공으로 만드는 방법이 중요해진다. 앞으로 점점 더 그렇게 될 것으로 예측한다.
이렇게 만들어진 인공 데이터로 다시 인공지능망이 학습한다. 그 학습 결과는 다른 응용 분야로 전이된다. 그 인공지능으로 인공지능 데이터를 만든다. 이제 인간이 파고들 틈이 없다. 인공지능이 인공 데이터도 만들고, 학습도 스스로 한다. 미래 인공지능의 모습이다. 모두 컴퓨터의 성능과 메모리 반도체의 성능이 높아져 가능하다. 인공 세상(Artificial World)이다. 데이터도 가상화(Virtualization)된다.
김정호 카이스트 전기 및 전자공학과 교수 joungho@kaist.ac.kr