AI 핵심 요약
beta- SK하이닉스는 20일 슈퍼컴퓨팅 2026에서 차세대 AI 메모리 기술을 공개했다
- 메모리 공유형 AI 랙 시스템으로 데이터 처리 효율과 GPU 활용도를 높였다
- 메모리 내 연산 기술과 HBM4E 등 차세대 제품군도 선보였다
!AI가 자동 생성한 요약으로 정확하지 않을 수 있어요.
D램 내부 연산·맞춤형 HBM 등 신기술 선봬
[서울=뉴스핌] 서영욱 기자 = SK하이닉스가 고대역폭메모리(HBM)를 넘어 메모리를 중심으로 인공지능(AI) 시스템 전체의 성능을 높이는 차세대 기술을 공개했다. 여러 서버가 메모리를 공유하고 데이터 사용 빈도에 따라 저장 공간을 배분하는 방식으로 AI 처리 효율을 끌어올리는 것이 핵심이다.
메모리 내부에서 직접 연산을 수행하는 기술까지 선보이며 AI 인프라 전반으로 사업 영역을 확대하고 있다.
20일 SK하이닉스에 따르면 회사는 지난 15일부터 미국 일리노이주 시카고에서 열린 '슈퍼컴퓨팅 2026(SC26)'에 참가해 차세대 메모리 솔루션과 AI 시스템 기술을 선보였다. 올해 행사에는 500여개 기업과 기관이 참가했으며 약 1만명이 전시장을 찾았다.
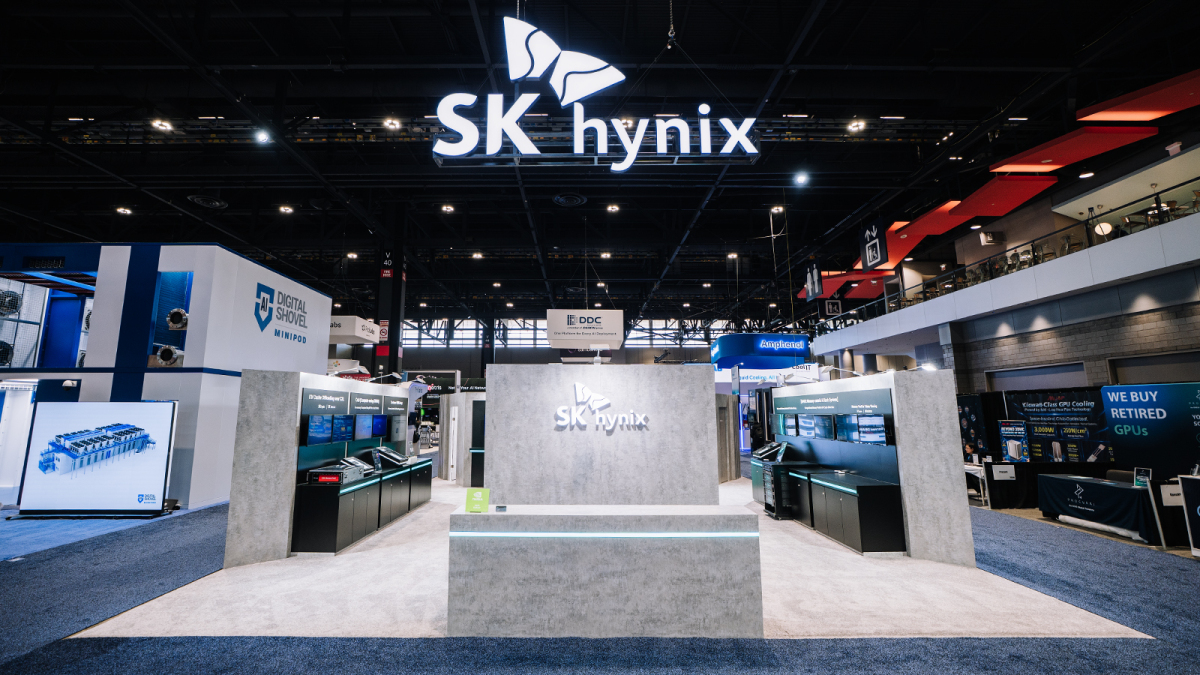
이번 전시의 핵심은 메모리 중심 AI 랙 시스템인 'MARS(Memory-centric AI Rack System)'다. 서버와 스토리지, 네트워크 장비 등을 하나의 랙에 통합하고 메모리 자원을 공유해 AI 시스템의 처리 효율을 높이는 기술이다.
SK하이닉스는 MARS와 관련한 세 가지 시연을 진행했다. 첫 번째는 차세대 인터페이스인 CXL을 활용해 여러 서버가 메모리를 공유하는 기술이다. AI가 이전 연산 결과를 저장하는 'KV 캐시'를 D램과 솔리드스테이트드라이브(SSD)에 나눠 보관하고 필요할 때 빠르게 불러오는 방식이다.
대용량 데이터는 SSD에 저장하고 재사용 가능성이 높은 데이터는 D램으로 미리 가져와 저장 용량과 처리 속도를 동시에 확보하도록 설계했다.
두 번째는 메모리 풀에 연산 기능을 추가한 기술이다. 여러 서버와 그래픽처리장치(GPU)가 데이터를 공유하면서 필요한 연산을 메모리 내부에서 처리해 데이터 이동에 따른 부담을 줄인다.
세 번째는 여러 중앙처리장치(CPU) 서버가 AI 데이터 처리에 필요한 토큰을 공유하는 기술이다. 이미지와 음성 등을 처리하는 멀티모달 AI 환경에서 중복 작업을 줄이고 GPU 대기 시간을 단축해 시스템 성능을 높이는 방식이다.
SK하이닉스는 SK텔레콤과 협력해 실제 대규모언어모델(LLM) 추론 환경에서 CXL 기반 메모리 공유 기술의 실증도 마쳤다. HBM과 D램에 우선적으로 필요한 데이터를 배치하고 사용 빈도가 낮은 데이터는 CXL 메모리 풀로 이동시켜 메모리 활용 효율을 높였다.
메모리 자체에 연산 기능을 부여하는 기술도 공개했다.
'Compute-using-DRAM'은 D램 셀의 전하 공유 원리를 활용해 메모리 내부에서 직접 연산하는 기술이다. 별도 연산 장치 없이 데이터 복사와 비교, 간단한 산술 연산 등을 수행해 데이터 이동량과 전력 소모를 줄일 수 있다.
맞춤형 HBM 기술인 'Custom HBM Array'도 선보였다. 연산 기능을 갖춘 여러 개의 HBM을 연결해 기존 GPU 시스템의 메모리 대역폭 한계를 보완하고 AI 추론 과정의 에너지 효율을 높이는 구조다.
차세대 제품군도 전시했다. HBM4E와 HBM4, HBM3E를 비롯해 256GB 서버용 DDR5 RDIMM, 192GB SOCAMM2 등 고용량·저전력 메모리와 기업용 SSD 제품을 공개했다.
SK하이닉스 관계자는 "메모리가 AI 인프라의 성능과 효율을 좌우하는 요소로 떠오르고 있다"며 "앞으로도 AI 컴퓨팅 성능을 높일 핵심 기술 파트너로서 고객과 함께 성장하겠다"고 말했다.
syu@newspim.com