AI 핵심 요약
beta- 카카오는 29일 개인화 AI 에이전트용 임베딩 모델 2종을 공개했다
- 공개 모델은 30억·13억 매개변수 규모로 한국어 검색 성능이 우수했다
- 두 모델은 벡터 크기 조절과 상업적 활용이 가능한 오픈 라이선스를 적용했다
!AI가 자동 생성한 요약으로 정확하지 않을 수 있어요.
한국어 검색 성능·추론 효율 개선
[서울=뉴스핌] 심재민 인턴기자 = 카카오는 개인화 인공지능(AI) 에이전트의 기반 기술인 임베딩 모델 '카나나2 임베딩(Kanana-2-embedding)' 2종을 오픈소스 플랫폼 허깅페이스(Hugging Face)에 공개했다고 29일 밝혔다.
이번에 공개한 모델은 30억개 매개변수 규모의 '카나나2 3B 임베딩(Kanana-2-3b-embedding)'과 13억개 규모의 '카나나2 1.3B 임베딩(Kanana-2-1.3b-embedding)'이다. 지난 7월 소형 언어모델(SLM) 4종을 공개한 데 이은 추가 오픈소스 공개다.
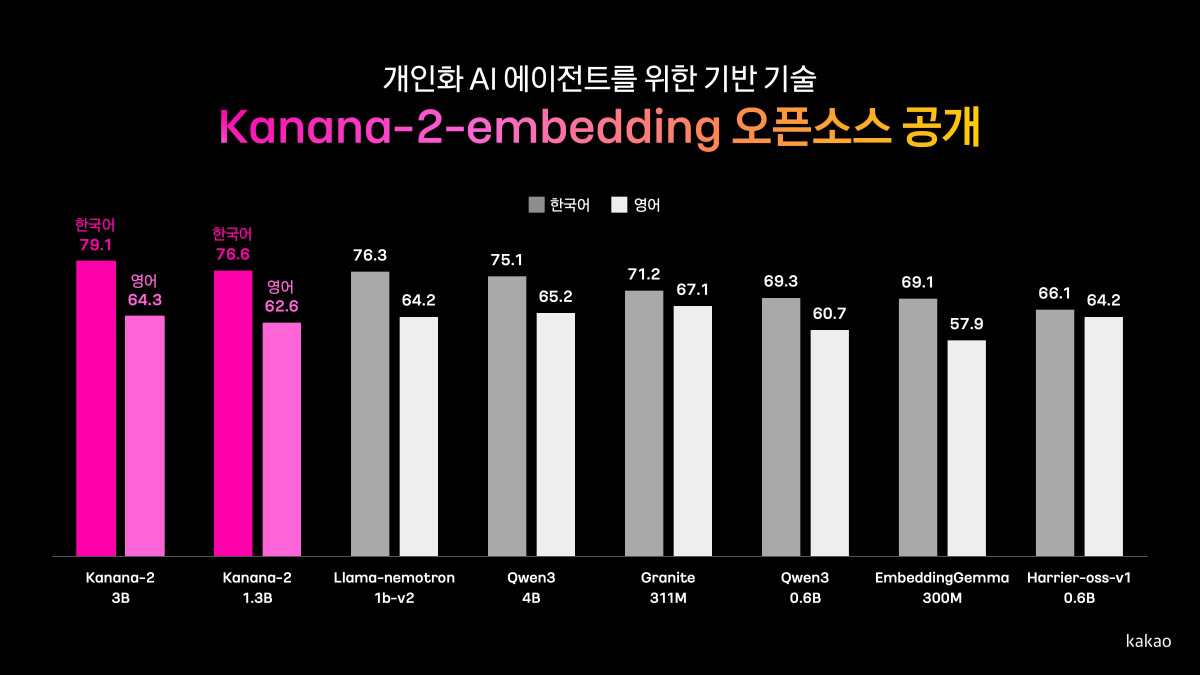
임베딩 모델은 텍스트의 의미를 숫자 벡터로 변환해 질문과 관련된 정보를 검색하는 AI 모델이다. 정확한 단어가 일치하지 않더라도 의미가 비슷한 정보를 찾을 수 있어 개인화 AI 에이전트와 검색 서비스 등에 활용된다.
카카오에 따르면 이번 모델은 유사 규모의 공개 모델인 '라마 네모트론 임베드(llama-nemotron-embed-1b-v2)', '큐원3 임베딩(Qwen3-Embedding-4B)'과 비교한 평가에서 가장 높은 한국어 성능을 기록했다. 영어 성능은 유사한 수준을 보였으며, 큐원3 임베딩보다 추론 효율이 높게 나타났다.
30억개 매개변수 모델은 자체 소형 언어모델 '카나나2 SLM(Kanana-2-SLM)'를 기반으로 개발했다. 13억개 모델에는 대형 모델의 학습 정보를 소형 모델에 전달하는 '지식 증류' 기술을 적용했다.
또한 임베딩 벡터의 크기를 조절할 수 있는 '마트료시카 표현 학습(MRL·Matryoshka Representation Learning)' 기술을 도입했다. 이를 통해 개발자는 검색 성능과 저장 공간, 처리 속도 등을 고려해 벡터 크기를 선택할 수 있다.
두 모델에는 연구·개발뿐 아니라 라이선스 조건에 따라 상업적으로도 활용할 수 있는 '카나나 오픈 라이선스'가 적용된다.
노병석 카카오 유니파이드 파운데이션 모델 성과리더는 "연구자와 개발자들이 한국어에 강점을 가진 임베딩 기술을 다양한 서비스에 활용할 수 있도록 돕고, 검색 성능과 효율을 함께 높이는 연구를 이어갈 것"이라고 말했다.
flurry327@newspim.com